Muestreo estratificado: pasos, asignación y ejemplo
Aprende muestreo estratificado con un ejemplo de asignación proporcional, pesos, media poblacional y diferencias frente a conglomerados y cuotas.
En pocas palabras
- Los estratos se definen antes de seleccionar y deben cubrir la población sin superposición.
- Una asignación desproporcionada exige ponderar según el diseño.
- La incertidumbre depende del diseño, la variabilidad y la fracción de muestreo.
En este artículo
El muestreo estratificado es un diseño probabilístico que divide la población en grupos llamados estratos y selecciona una muestra dentro de cada uno. Los estratos deben ser mutuamente excluyentes y, en conjunto, cubrir la población definida. Su propósito puede ser mejorar la precisión, asegurar observaciones suficientes de subgrupos relevantes o combinar ambos objetivos.
La diferencia decisiva no consiste en formar grupos con nombres, sino en establecer cómo se selecciona dentro de ellos y cómo se reconstruye después el resultado poblacional. Este artículo explica asignación, probabilidades y ponderaciones mediante un ejemplo universitario. Todos los tamaños y resultados presentados son hipotéticos; no corresponden a una encuesta real.
Cómo definir la población y los estratos
Suponga que interesa estudiar el tiempo semanal dedicado a una actividad académica entre estudiantes matriculados en una institución. Primero defina quién pertenece a la población y en qué fecha. Después identifique una variable disponible en el marco de muestreo, como turno, campus o programa. Sin esa información previa no es posible organizar la selección estratificada de la forma planteada.
Cada unidad debe quedar en un único estrato. Si se utilizan categorías que se superponen, una persona puede quedar representada más de una vez; si faltan categorías, parte de la población queda excluida. “Estudiantes que usan biblioteca” y “estudiantes que trabajan” no forman por sí solos una partición: una misma persona puede cumplir ambas condiciones.
Qué distingue estratos, conglomerados y cuotas
| Diseño | Cómo intervienen los grupos | Punto decisivo |
|---|---|---|
| Estratificado | Se seleccionan unidades dentro de todos los estratos del diseño. | Hay selección probabilística y probabilidades conocidas. |
| Por conglomerados | Se seleccionan algunos grupos, y luego sus unidades o una muestra de ellas. | La selección incluye el nivel de los conglomerados. |
| Por cuotas | Se busca completar cantidades por categorías. | Si la selección interna es discrecional, no es probabilística. |
- Diseño
- Estratificado
- Cómo intervienen los grupos
- Se seleccionan unidades dentro de todos los estratos del diseño.
- Punto decisivo
- Hay selección probabilística y probabilidades conocidas.
- Diseño
- Por conglomerados
- Cómo intervienen los grupos
- Se seleccionan algunos grupos, y luego sus unidades o una muestra de ellas.
- Punto decisivo
- La selección incluye el nivel de los conglomerados.
- Diseño
- Por cuotas
- Cómo intervienen los grupos
- Se busca completar cantidades por categorías.
- Punto decisivo
- Si la selección interna es discrecional, no es probabilística.
Una encuesta que pide “cincuenta respuestas de cada carrera” y acepta a las primeras personas disponibles cumple una cuota, pero no el mecanismo aleatorio requerido por el ejemplo estratificado. El equilibrio visible de las categorías no demuestra ausencia de sesgo. Para sostener inferencias debe describirse el procedimiento de selección, no solamente el aspecto final de la muestra.
La estratificación puede aumentar la precisión cuando la variable usada separa grupos con comportamientos diferentes respecto de la característica estudiada. No garantiza una mejora automática para cualquier variable. Si el criterio de agrupación guarda poca relación con el resultado, el beneficio puede ser limitado, aunque siga siendo útil asegurar un número de observaciones por subgrupo.
Asignación proporcional de la muestra
La asignación o afijación indica cuántas unidades se seleccionan en cada estrato. En la proporcional se usa nₕ = n × Nₕ/N, donde Nₕ es el tamaño poblacional del estrato, N el tamaño total y n la muestra total. Los tamaños deben ajustarse a números enteros sin perder la suma total ni superar las unidades disponibles.
Imagine una población de mil estudiantes dividida por turno: seiscientos en el diurno y cuatrocientos en el vespertino. Para una muestra de cien, la asignación proporcional selecciona sesenta y cuarenta, respectivamente. Si dentro de cada estrato se aplica muestreo aleatorio simple sin reemplazo, todas las unidades tienen probabilidad de inclusión 0,10 y peso base 10.
| Estrato | Población Nₕ | Muestra nₕ | Peso Nₕ/nₕ |
|---|---|---|---|
| Diurno | 600 | 60 | 10 |
| Vespertino | 400 | 40 | 10 |
| Total | 1.000 | 100 | No se suman los pesos de esta columna. |
- Estrato
- Diurno
- Población Nₕ
- 600
- Muestra nₕ
- 60
- Peso Nₕ/nₕ
- 10
- Estrato
- Vespertino
- Población Nₕ
- 400
- Muestra nₕ
- 40
- Peso Nₕ/nₕ
- 10
- Estrato
- Total
- Población Nₕ
- 1.000
- Muestra nₕ
- 100
- Peso Nₕ/nₕ
- No se suman los pesos de esta columna.
Asignación desproporcionada y ponderaciones
Puede interesar analizar mejor un estrato pequeño y asignarle una muestra relativamente mayor. Eso no invalida el diseño: modifica las probabilidades de selección. En la misma población, seleccionar cincuenta estudiantes de cada turno implica fracciones de muestreo distintas. El turno diurno tiene probabilidad 50/600 y peso 12; el vespertino tiene probabilidad 50/400 y peso 8.
El peso base representa cuántas unidades de la población están representadas por una unidad seleccionada bajo el diseño. No es una puntuación de importancia personal ni un premio por responder. Cuando las probabilidades son diferentes, tratar cada respuesta como si representara la misma cantidad puede distorsionar la estimación del conjunto.
La misma cuenta puede escribirse con pesos individuales: (50 × 12 × 10 + 50 × 8 × 20)/(50 × 12 + 50 × 8) = 14. No se trata de elegir el número más conveniente, sino de aplicar el estimador correspondiente al diseño. Si se usara la muestra proporcional de sesenta y cuarenta, la media sin ponderar coincidiría con esa combinación en este ejemplo.
Cómo calcular la media y su incertidumbre
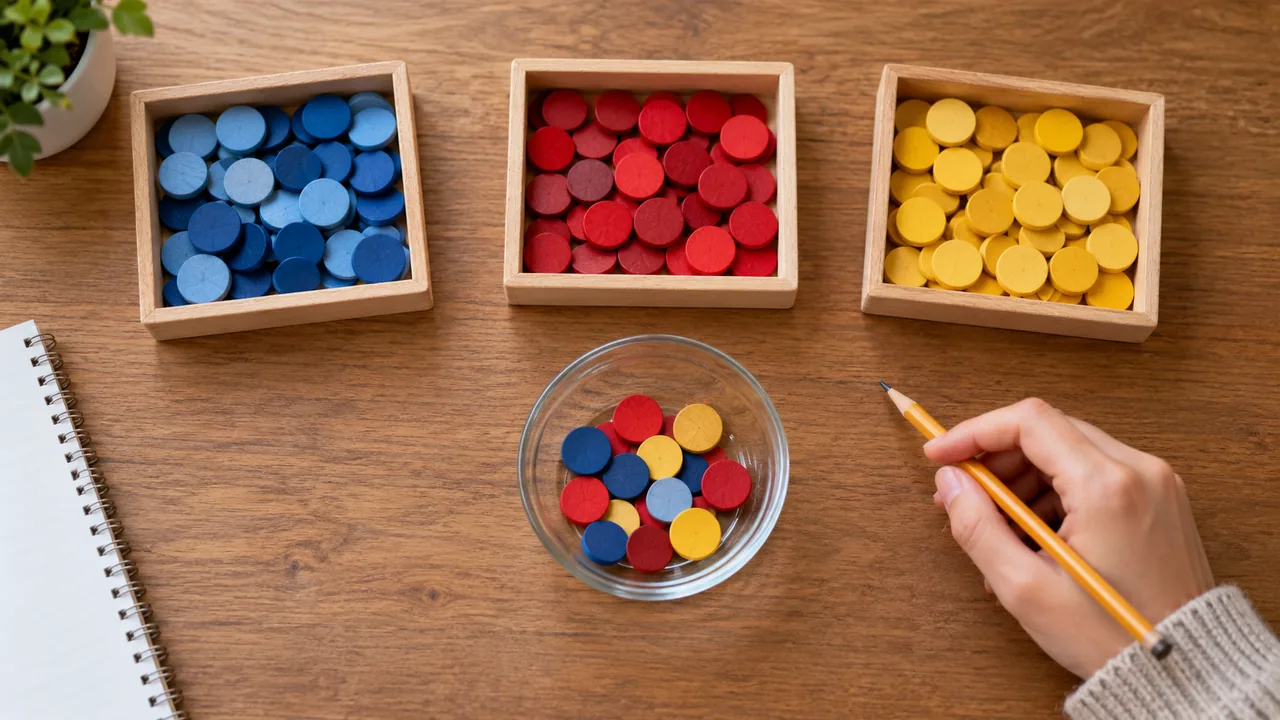
En un diseño estratificado con selección aleatoria simple dentro de cada estrato, la media se estima como la suma de Wₕ × mediaₕ, donde Wₕ = Nₕ/N. Para una variable binaria, cada media de estrato puede ser una proporción. La idea es reconstruir el conjunto usando tamaños poblacionales conocidos, no la participación accidental de cada grupo entre quienes respondieron.
La varianza estimada de esa media puede escribirse como Σ Wₕ²(1 − fₕ)sₕ²/nₕ, bajo el diseño descrito, donde fₕ = nₕ/Nₕ y sₕ² es la varianza muestral del estrato. El factor 1 − fₕ es la corrección por población finita. Si se toma un censo de un estrato, esa contribución de selección desaparece en este modelo.
Para estimar una varianza dentro del estrato hacen falta observaciones suficientes; una sola unidad no permite calcular la varianza muestral usual. Un intervalo de confianza necesita además criterios adecuados sobre la distribución del estimador y sus grados de libertad. El número de respuestas, por sí solo, no produce un margen de error universal. Revise la diferencia entre descripción e inferencia estadística.
Qué aporta la asignación de Neyman
Cuando los costos de observar unidades son similares y se conocen o se estiman variabilidades por estrato, la asignación de Neyman distribuye nₕ proporcionalmente a NₕSₕ. Un estrato grande y variable recibe más observaciones que otro pequeño y homogéneo. La fórmula se refiere a un objetivo de precisión definido; no es una receta para cualquier encuesta con múltiples indicadores.
Si los costos difieren, pueden incorporarse al problema de asignación. También deben respetarse mínimos analíticos, máximos poblacionales y restricciones presupuestarias. Una solución calculada con datos piloto poco confiables puede ser menos útil que una asignación más sencilla y bien justificada. La optimización no sustituye la calidad del marco ni la ejecución aleatoria del diseño.
No respuesta y cobertura: problemas distintos
También hay errores de cobertura cuando el marco deja fuera unidades que sí pertenecen a la población. La estratificación de una lista incompleta no recupera automáticamente a quienes faltan. Documente duplicados, registros desactualizados y criterios de elegibilidad, y explique a qué población permiten referirse los resultados. Un informe transparente separa error de muestreo de otras fuentes de error.
Guía para planear una selección estratificada
Decisiones que deben quedar documentadas
- Defina población, unidad y fecha de referencia.
- Verifique que el marco contiene todas las unidades elegibles y la variable de estratificación.
- Construya estratos exhaustivos y mutuamente excluyentes.
- Asigne la muestra y registre cómo resolverá redondeos y mínimos.
- Seleccione aleatoriamente dentro de cada estrato y conserve probabilidades.
- Calcule estimaciones y errores con el diseño, y describa cobertura y no respuesta.
Antes de salir a campo, formule con claridad las preguntas de una investigación cualitativa y sus límites metodológicos si combina enfoques: la lógica de una muestra probabilística no se transfiere sin cambios a una selección intencional de entrevistas. Cada componente debe justificar qué tipo de conclusión permite obtener.
Preguntas frecuentes sobre muestreo estratificado
¿Se toma la misma cantidad de personas de cada estrato?
No necesariamente. La asignación puede ser proporcional, igual o responder a criterios de precisión y costo. Lo importante es registrar las probabilidades y usar una estimación coherente con ellas.
¿Tener cuotas convierte una muestra en estratificada?
No. Si las personas se eligen por disponibilidad o decisión del encuestador, el mecanismo interno no es probabilístico. Completar cantidades por categoría no sustituye una selección aleatoria bien definida.
¿Puedo ignorar los pesos si la muestra parece equilibrada?
No por ese motivo. Revise las probabilidades de inclusión y el objetivo de la estimación. En asignaciones desproporcionadas, una media simple puede representar la composición de la muestra y no la de la población.
Referencias
- Statistics Canada. Statistics: Power from Data!, 3.2.2: Probability sampling. https://www150.statcan.gc.ca/n1/edu/power-pouvoir/ch13/prob/5214899-eng.htm
- Statistics Canada. Statistics: Power from Data!, 3.2.3: Non-probability sampling. https://www150.statcan.gc.ca/n1/edu/power-pouvoir/ch13/nonprob/5214898-eng.htm
- Statistics Canada. Survey Methodology: Stratified sampling and the optimal allocation problem. https://www150.statcan.gc.ca/n1/pub/12-001-x/2015002/article/14249/02-eng.htm
- Statistics Canada. Survey Methods and Practices. https://www150.statcan.gc.ca/n1/en/pub/12-587-x/12-587-x2003001-eng.pdf
Autoría
Study Mais
Sigue estudiando
Muestreo aleatorio simple: selección y ejemplo resuelto
Aprende a aplicar el muestreo aleatorio simple sin reposición, calcular probabilidades de selección y estimar una media con su incertidumbre y condiciones.
Hipótesis nula: formulación, contraste y ejemplos claros
Comprende qué afirma la hipótesis nula, cómo se contrasta y qué significan el valor p, los errores de decisión y un resultado que no permite rechazarla.
Probabilidad binomial: fórmula y ejemplos resueltos
Aprende cuándo usar la probabilidad binomial, calcula eventos exactos y acumulados, y verifica un ejemplo paso a paso con n = 5.